
Come automatizzare un data workflow dal project management alla business intelligence
Uno use case per trasformare dati dispersi in reportistica continua e governata
Negli ultimi anni molte organizzazioni hanno investito in strumenti di business intelligence e data visualization, come PowerBI o Tableau, e in piattaforme di Project management, come Jira, Asana, Monday.com, per avere controllo operativo, dati più precisi e insight utili per prendere decisioni data-driven.
In molti casi, però, l’integrazione tra questi strumenti non è orchestrata. Il risultato è che, anche in contesti Enterprise, l’aggiornamento della reportistica richiede interventi manuali o semi-manuali, con impatti su efficienza, tracciabilità e governance.
Il collo di bottiglia non è la visualizzazione del dato ma il modo in cui in cui il data workflow viene gestito: come il dato viene raccolto, trasformato e aggiornato.
Questo tema è centrale anche per un altro ambito sempre più presente nelle conversazioni aziendali: l’intelligenza artificiale. Chi vuole introdurre soluzioni AI-based deve prima garantire dati strutturati, coerenti, aggiornati e tracciabili. Senza queste basi, anche il modello più evoluto rischia di produrre risultati poco affidabili.
Quando il dato diventa un problema operativo
In molti contesti, i dati operativi risiedono in strumenti differenti, utilizzati quotidianamente dai vari team, come sistemi di ticketing, di project management e così via.
La reportistica a supporto del management e dei c-level, che deve incrociare tutti queste tipologie di dati, però, viene spesso alimentata da processi manuali o semi-manuali o da strumenti non idonei allo scopo, come l’uso di automazioni e funzioni macro eseguite in Excel.
Questo approccio, sebbene inizialmente efficace, tende nel tempo a mostrare limiti evidenti:
- forte dipendenza dall’intervento umano
- fragilità del processo (riferimenti che cambiano, copie manuali, controlli ripetuti)
- aggiornamenti poco frequenti
- difficoltà nel garantire coerenza e affidabilità del dato
Il risultato è che attività a basso valore ma time-consuming assorbono il tempo di risorse qualificate mentre il dato, che dovrebbe supportare decisioni rapide e strategiche, diventa un elemento di incertezza.
A questa dimensione operativa si aggiunge anche un tema di cybersecurity. Ad esempio, le macro VBA di Excel possono essere sfruttate in campagne di phishing e macro malware e, in alcuni scenari, facilitare attività di data exfiltration o l’esecuzione di codice non autorizzato. Inoltre, la gestione di logiche critiche in file locali rende più complesso garantire tracciabilità e controllo delle modifiche.
In questo articolo raccontiamo il progetto realizzato per una realtà aziendale strutturata, con cui abbiamo modernizzato e automatizzato il data workflow dei propri dati operativi, a partire da una situazione comune a molte organizzazioni complesse.
La situazione di partenza: dati operativi, processi manuali e rischi nascosti
L’azienda aveva la necessità di produrre report direzionali per monitorare KPI operativi ed economici. I report dovevano confrontare i dati dinamici operativi del software di project management con i dati statici forniti dal management come benchmark, per misurare l’andamento e individuare eventuali scostamenti rispetto agli indicatori di riferimento.
Il metodo precedente prevedeva l’utilizzo di:
- Software di project management (PM), per la gestione progetti e il ticketing, come fonte primaria di dati
- Excel, per l’inserimento manuale di informazioni gestionali e attività di analisi.
Il metodo utilizzato era semi-manuale. La non completa affidabilità delle automazioni create su Excel rendeva necessario un controllo umano continuo sulla correttezza dei dati.
In questo contesto, l’uso di automazioni basate su macro VBA introduce un potenziale rischio di sicurezza e richiede maggiori controlli su tracciabilità e gestione delle modifiche. Per esigenze di compliance, è fondamentale che strumenti e processi utilizzati per gestire e trasformare i dati siano sicuri e governabili.
A questo si aggiunge la complessità dei file e la numerosità dei dati, che potevano creare errori non facilmente identificabili ma potenzialmente dannosi. Se non individuato, infatti, un errore poteva essere perpetuato e riportato nel tempo, andando ad incidere anche sulle analisi successive.
Questo è un punto critico per aziende che vogliono prendere decisioni aziendali data-driven, perché implica la possibilità che il dato su cui si basa una decisione strategica sia potenziale errato.
Insieme all’azienda, quindi, abbiamo progettato un nuovo data workflow completamente automatizzato, con l’obiettivo di:
- eliminare le attività manuali
- aumentare la frequenza di aggiornamento dei dati
- garantire coerenza e tracciabilità lungo tutta la pipeline
- aumentare la robustezza del flusso dati
- ridurre l’esposizione al rischio cyber, adottando un workflow governato, centralizzato e strumenti più controllabili
L’approccio al progetto
Il progetto si è basato su un approccio consulenziale, in cui è stata indispensabile la piena collaborazione da parte dell’azienda. Questo ha permesso ai tecnici Sinthera di entrare all’interno dei loro processi, per comprendere sul campo il funzionamento della procedura esistente e capire le necessità da risolvere.
Questa modalità ha permesso la progettazione di un sistema di gestione dati affidabile e sostenibile nel tempo, adatta alla propria realtà aziendale e in grado di produrre risultati in linea con gli standard aziendali da rispettare.
L’architettura: un flusso dati chiaro, automatizzato e tracciabile
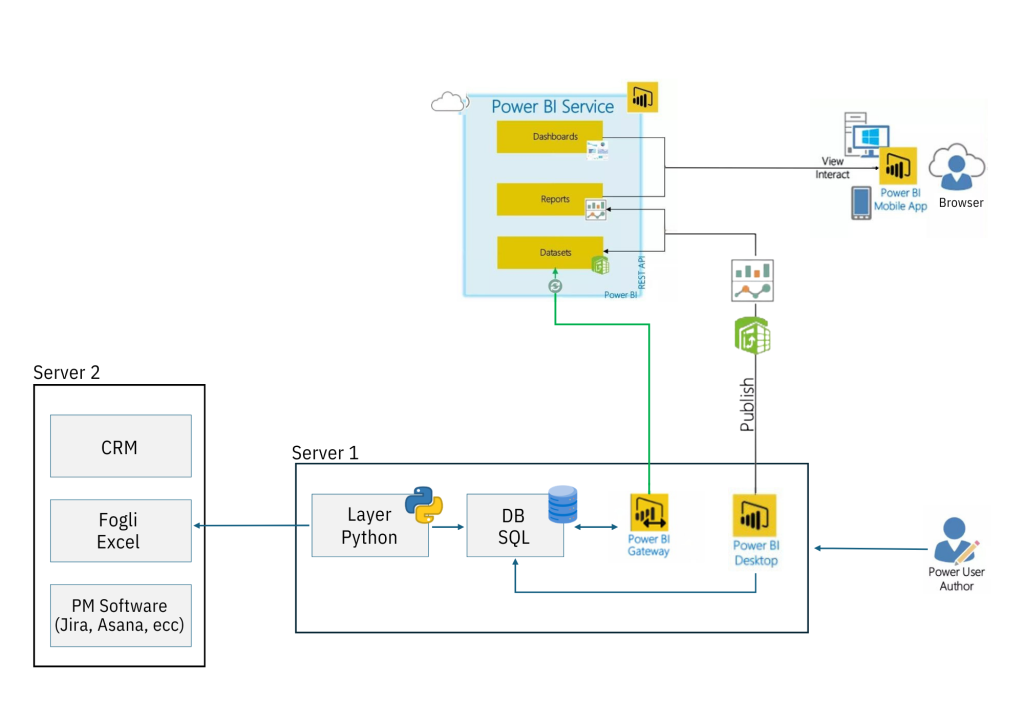
L’architettura è stata progettata per operare in ambiente on-premise, integrandosi con i sistemi esistenti senza introdurre dipendenze superflue.
Il flusso dati è stato strutturato in modo chiaro e tracciabile, per poter intervenire in modo rapido in caso di imprevisti e malfunzionamenti:
- estrazione automatica dei dati dalle fonti operative aziendali con Python
- elaborazione e trasformazione con Python: normalizzazione, arricchimento e calcolo degli indicatori
- persistenza strutturata su database relazionale
- reportistica finale su piattaforma di business intelligence
Orchestrazione intelligente delle pipeline
Un elemento chiave del progetto è stato il disegno dell’orchestrazione delle pipeline Python, ossia la sequenza di task eseguiti da Python per l’estrazione e l’elaborazione dei dati.
Le pipeline sono state organizzate tramite orchestratori dedicati, con logiche di aggiornamento differenziate in base alla frequenza richiesta dai diversi dataset, ottimizzando le risorse ed evitando refresh non necessari.
Dati sempre disponibili, senza intervento umano
Le tabelle SQL alimentano direttamente i report preconfigurati in Power BI, che vengono aggiornati seguendo le stesse logiche di orchestrazione delle pipeline Python. Il risultato di questa modernizzazione del flusso dati è un sistema di reportistica in cui:
- i dati sono costantemente aggiornati
- i report sono immediatamente disponibili agli stakeholder
- non è richiesto alcun intervento manuale.
La reportistica diventa così uno strumento affidabile, facilmente accessibile e rapido su cui basare decisioni operative e strategiche.
I risultati: report affidabili e processi stabili, pronti per scalare
L’impatto di un data workflow automatizzato non si è limitato all’aspetto tecnico. Il risultato principale è stato la riduzione dell’incertezza legata a controlli manuali, a favore di un processo più stabile e governabile.
Infatti, il nuovo modello ha permesso di:
- eliminare attività manuali ripetitive
- recuperare il tempo delle risorse qualificate
- aumentare la fiducia nel dato, grazie ad una pipeline chiara e tracciabile
- ridurre il rischio di errori silenti e della loro propagazione del tempo
- ridurre l’esposizione al rischio cyber, sostituendo file e macro con pipeline eseguite in modo controllato e centralizzato.
In particolare, il miglioramento della qualità del lavoro delle persone coinvolte rappresenta uno dei risultati più rilevanti del progetto. Riducendo attività ripetitive e controlli manuali, il nuovo workflow ha reso il processo più chiaro e partecipato, permettendo a tutte le risorse coinvolte di concentrarsi su attività a maggiore valore.
Infine, ora che i processi sono stati semplificati e razionalizzati, l’azienda potrà aggiungere in autonomia nuove logiche di analisi e insight, prima evitate per la paura di impattare negativamente il codice legacy.